

Flux audio & transcription
Capter radios, flux en direct et caméras IP en continu, les transcrire en texte horodaté et classer ce texte par sujets
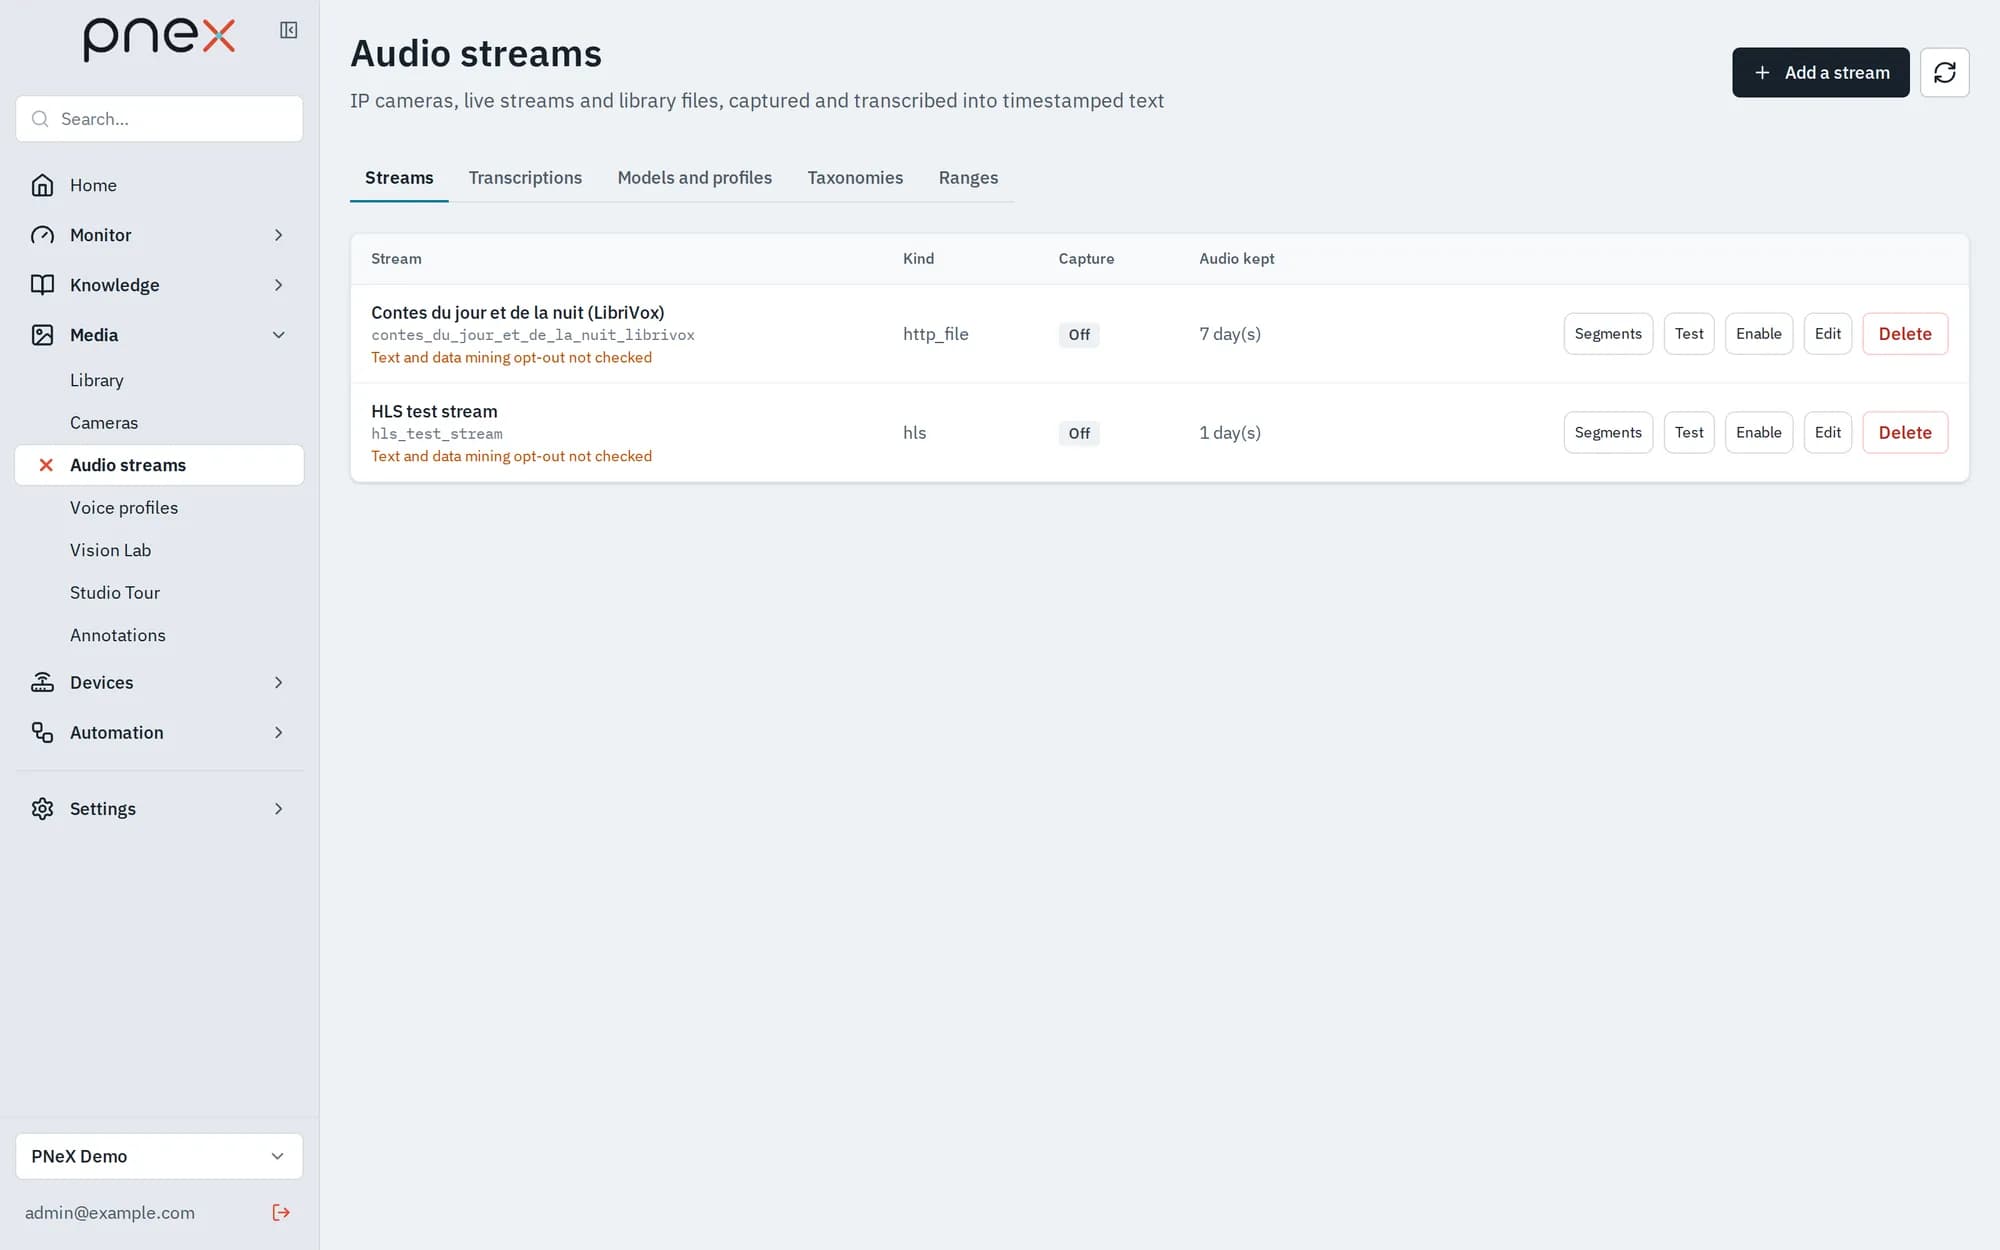
Médias › Flux audio liste les radios, flux en direct et caméras IP que l’organisation capte en continu. L’audio d’un flux est découpé en courts segments puis transcrit en texte horodaté ; seul le texte est conservé durablement. La vidéo d’un flux, si vous la demandez, alimente les nœuds caméra des flows.
La page compte cinq onglets : Flux, Transcriptions, Modèles et profils, Taxonomies et Plages.
Ajouter un flux
Ajouter un flux ouvre le formulaire :
- Nom et Type :
icecastpour une radio en continu,hlspour une playlist.m3u8,http_filepour un fichier unique comme un épisode de podcast,rtsppour une caméra IP,media_assetpour rejouer une vidéo ou un son de la médiathèque. - URL du flux, ou pour
media_assetle Fichier de la médiathèque (vidéo MP4/MOV ou audio MP3/AAC/OGG/FLAC/WAV, 512 Mo au plus). Le fichier est joué une fois à sa vitesse normale, puis le flux se désactive tout seul. - Pistes : Audio (transcription), Vidéo (bus caméra) ou Audio et vidéo. Avec la vidéo, choisissez les Images par seconde (1 à 5). La vidéo fonctionne avec les sources RTSP, HLS et MPEG-TS / MP4 en H.264, H.265 ou MJPEG.
- Secret d’accès (en-tête ou identifiants) : saisi, ou choisi dans le coffre de l’organisation. Il n’est envoyé qu’à l’hôte de l’URL. Une URL qui contient un jeton ou un mot de passe est refusée : les identifiants vont toujours dans le secret.
- Profil de transcription : le modèle de reconnaissance vocale utilisé pour les nouveaux segments (voir plus bas). Un flux uniquement vidéo n’en a pas besoin.
- Durée d’un segment (s) (10 à 120) et Conservation de l’audio : aucune (audio supprimé après transcription, par défaut), un nombre de jours, ou conservé quand l’organisation détient les droits.
- Lieu de capture : Ce serveur, Un worker de capture géré par la plateforme, ou un Boîtier de capture : un des agents edge de l’organisation dont la capture média est activée, par exemple un Raspberry Pi branché à un tuner TV. Le boîtier capte sur son propre réseau et envoie l’audio par son lien chiffré d’appareil ; il ne détient jamais de clé de stockage. Un boîtier ne capte que l’audio.
- Canal d’alerte : où part l’alerte de silence, en plus de la notification dans l’application.
Tester capte les premières secondes du flux et les transcrit avec son profil, sans rien stocker : de quoi vérifier l’URL et le profil avant d’Activer le flux.
Caméras IP (RTSP)
Une caméra IP est un flux de type rtsp avec une piste vidéo. Mettez utilisateur:mot de passe dans le secret d’accès, jamais dans l’URL. La connexion se fait en TCP uniquement
et les redirections sont refusées. Dans un flow, le nœud Source caméra, source Flux
média (caméra IP), lit ses images comme celles d’un appareil caméra : voir
Caméras & vision. Le bouton Enregistrements du flux liste
la vidéo écrite par un nœud Enregistrement vidéo.
Avant de capter un flux tiers, vérifiez que l’éditeur ne s’est pas opposé à la fouille de textes et de données (conditions, robots.txt, mentions), puis cochez Opposition à la fouille de textes et de données vérifiée. D’ici là, la liste affiche un avertissement. Chaque organisation capte un nombre limité de flux, fixé par la plateforme.
Santé de la capture et alerte de silence
Sous chaque flux activé, une ligne donne le temps écoulé depuis le dernier son, l’âge du plus ancien segment en attente de transcription et la part de la dernière heure effectivement transcrite. L’état indique En capture, Démarrage, Nouvel essai bientôt (avec la raison : flux injoignable, format non pris en charge, boîtier de capture hors ligne…) ou Arrêté.
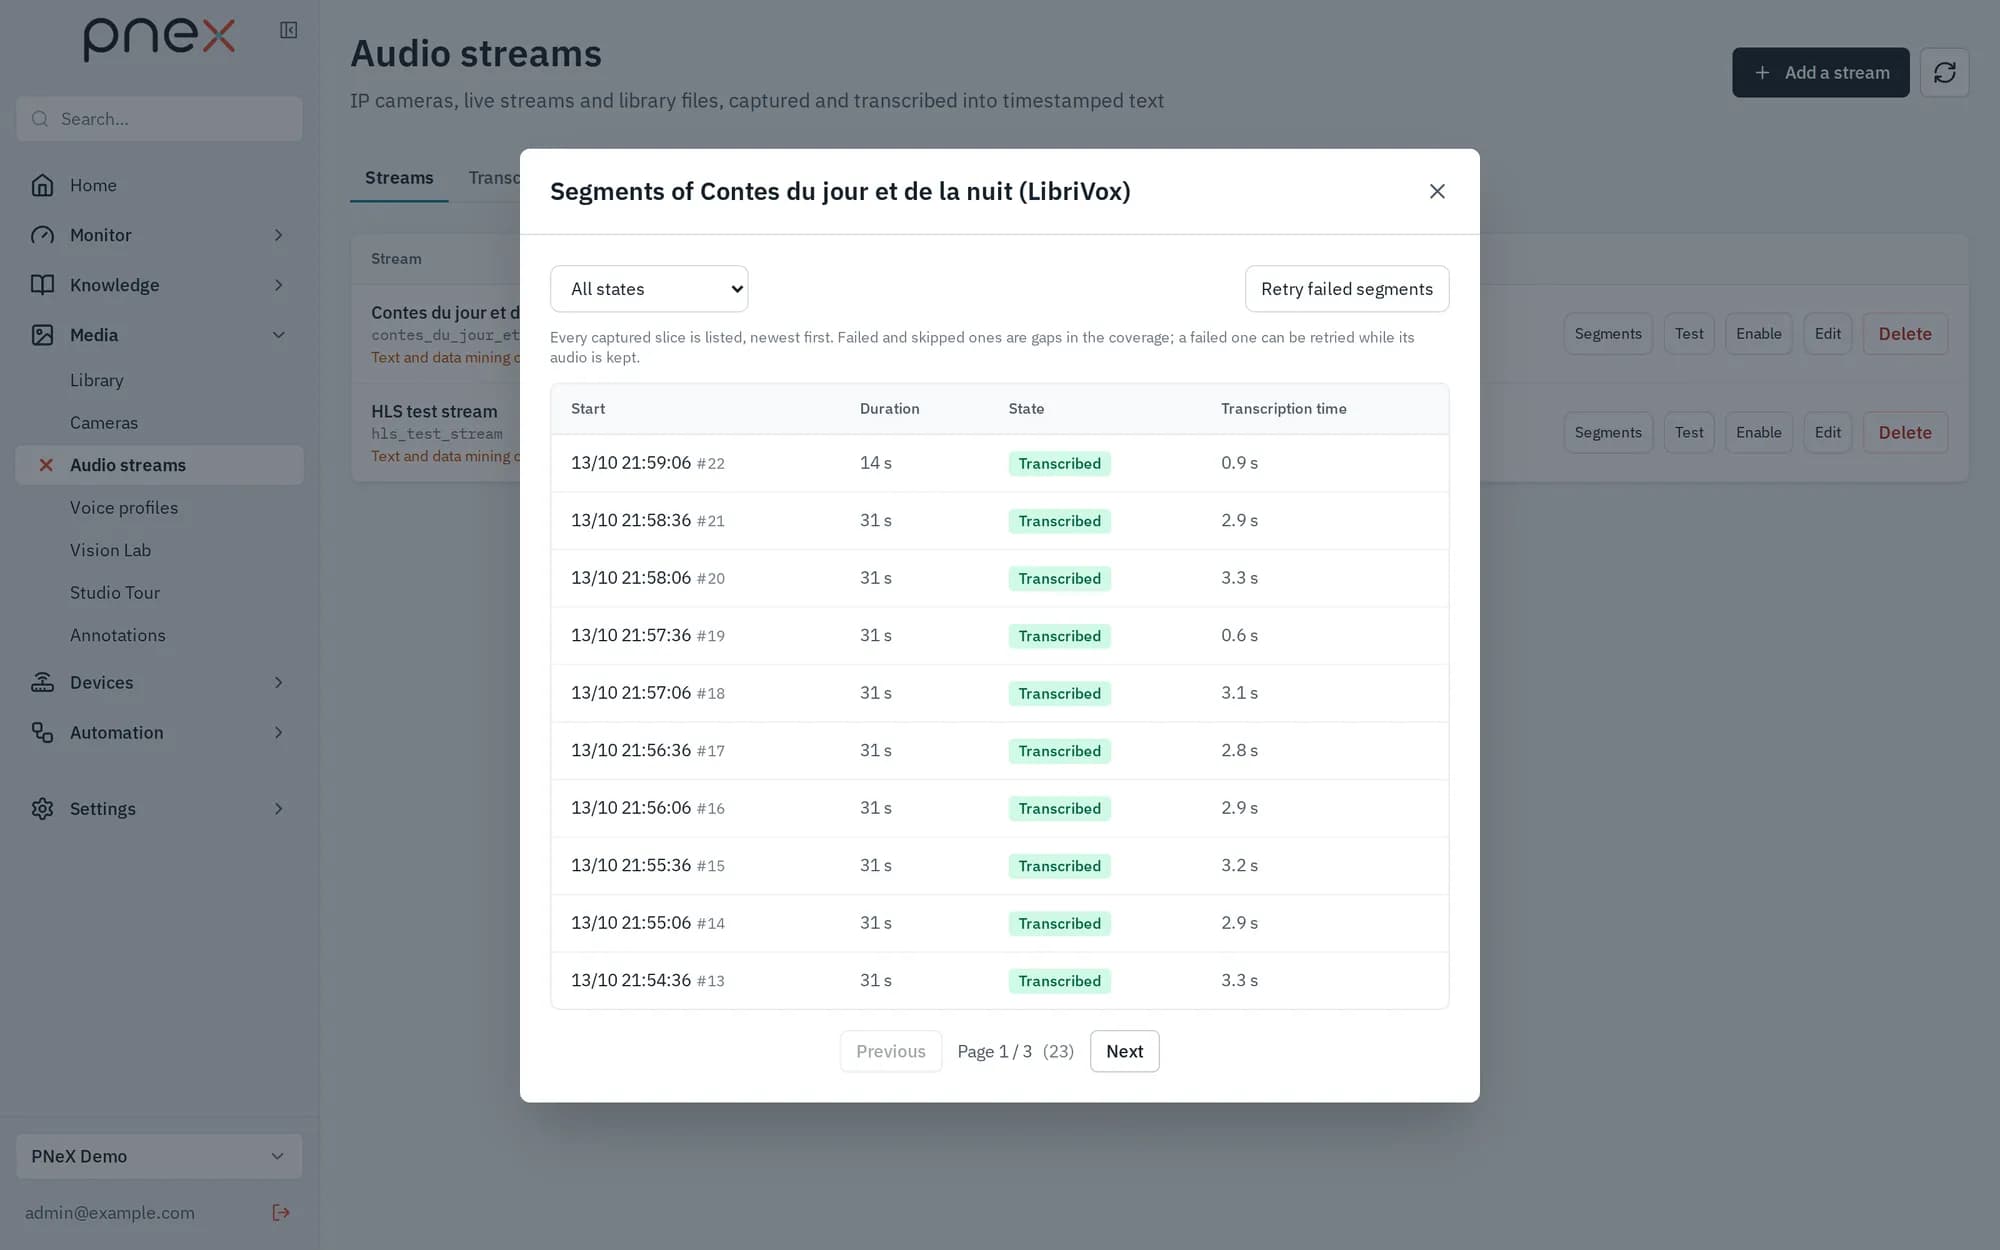
Segments liste chaque tranche captée avec son état (Capté, En file, En transcription, Transcrit, En échec, Silence (sauté), Trop tard (sauté)). Relancer les segments en échec renvoie à la transcription ceux dont l’audio est encore conservé. Les segments trop en retard sur le direct sont sautés volontairement, pour que le texte suive le direct.
Quand un flux activé n’apporte aucun son pendant 2 minutes, l’organisation reçoit une notification « Stream X is silent » (les notifications système sont rédigées en anglais), et un message sur le Canal d’alerte du flux s’il y en a un. Une alerte par silence ; elle se réarme dès que le son revient. L’alerte ne surveille que l’audio : un flux uniquement vidéo ne la déclenche jamais.
Modèles et profils
PneX n’embarque aucun modèle de parole : vous importez ceux que vous voulez faire tourner.
- Importer un modèle : téléversez une archive sherpa-onnx
.tar.bz2ou un fichier GGML whisper.cpp, ou prenez-en un Depuis la médiathèque, avec sa Licence du modèle. Le serveur reconnaît la famille, charge le modèle et transcrit un extrait de référence : la ligne indique combien de flux en temps réel il tient et son taux d’erreur sur l’extrait. Vérifier relance cette mesure. Tester transcrit un fichier audio que vous déposez (ses 2 premières minutes) et affiche le texte et le temps de calcul. - Importez de la même façon les modèles d’appoint, en fichiers
.onnxuniques : Détection de voix (par exemple Silero VAD) et, pour la diarisation, Diarisation : empreinte de locuteur puis Diarisation : segmentation (l’empreinte d’abord : la segmentation est vérifiée avec elle). - Ajouter le profil : Nom du profil, Modèle de transcription, Détection de voix facultative, Diarisation : segmentation + Diarisation : empreinte de locuteur facultatives, et la Langue (fr, en… ou auto). Choisissez ensuite ce profil dans le flux.
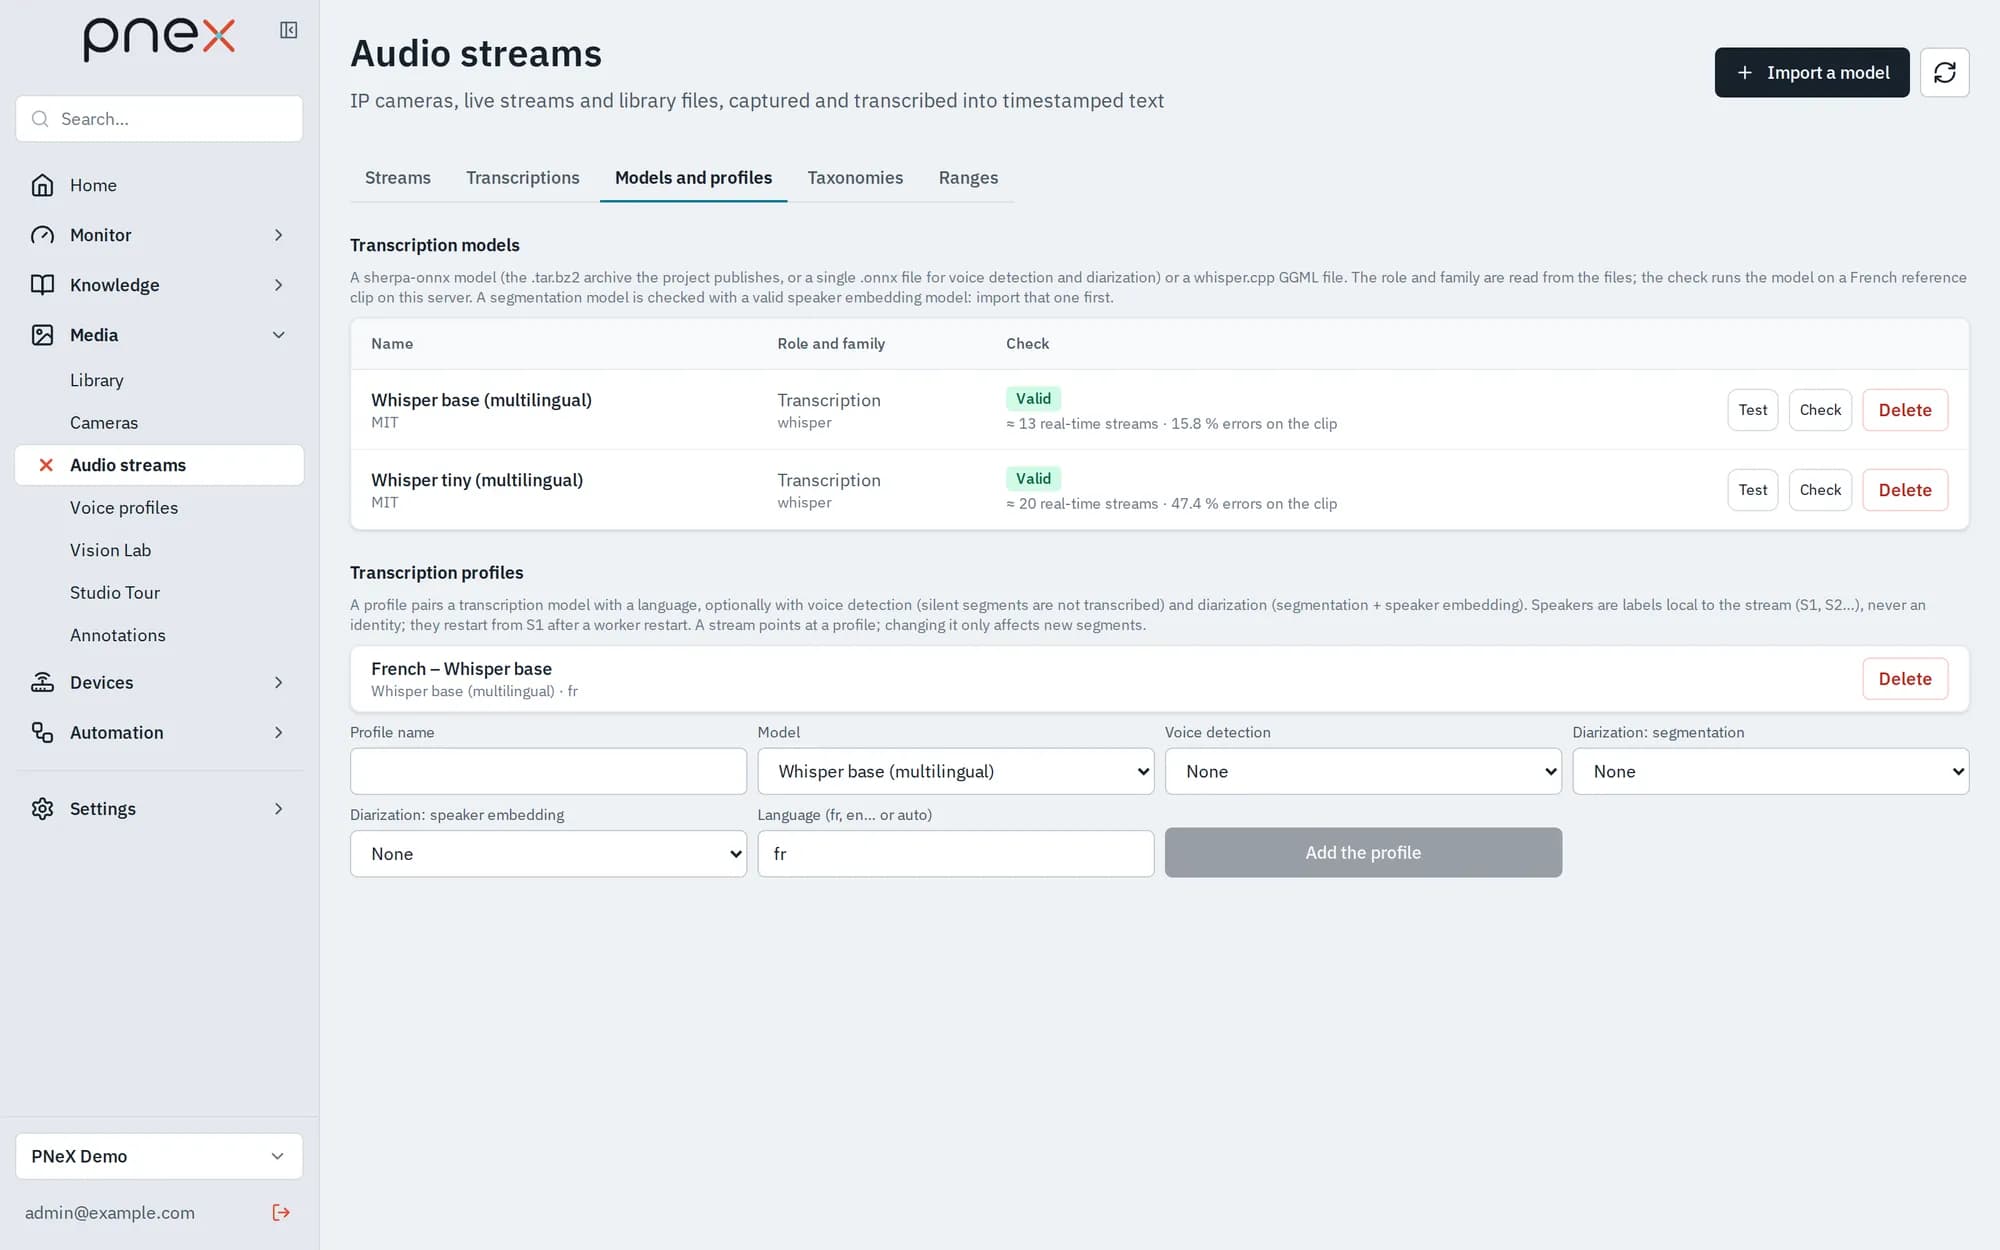
Avec la détection de voix, un segment sans parole n’est pas transcrit et apparaît en
Silence (sauté). La durée de parole de chaque segment est écrite dans la série
media_speech_seconds (label stream), prête pour un tableau de bord.
Avec la diarisation, chaque transcription porte des tours de parole étiquetés S1,
S2… Ces étiquettes sont propres au flux : elles disent « la même voix qu’à l’instant »,
jamais qui parle. Elles repartent de zéro après 30 minutes sans entendre cette voix ou
quand la transcription redémarre. Le temps de parole par étiquette est écrit dans
media_speaker_seconds (labels stream, speaker). Nommer un locuteur relève de sources
externes (grilles, annonces, plages), jamais de la voix. Reconnaître une personne
consentante à sa voix est une fonction distincte et volontaire : voir
Empreintes vocales.
Supprimer un modèle supprime les profils qui l’utilisent ; leurs flux ne sont plus transcrits tant qu’un autre profil n’est pas choisi.
Transcriptions
L’onglet Transcriptions cherche dans le texte de tous les flux, ou d’un seul, du plus récent au plus ancien (Rechercher dans le texte…). Dans un flow, le nœud Source média émet un message par segment transcrit des flux qu’il liste, avec le texte, la langue, le modèle et, avec la diarisation, les tours de parole. Rien n’est émis pendant les silences.
Plages horaires
Une plage est un intervalle nommé d’un flux ou de toute l’organisation : une émission, un journal, un poste de travail, un lot de production. Elle a un horaire prévu (annoncé par une grille) et/ou un horaire réel (ce qui s’est vraiment passé) ; les statistiques utilisent le réel quand il existe.
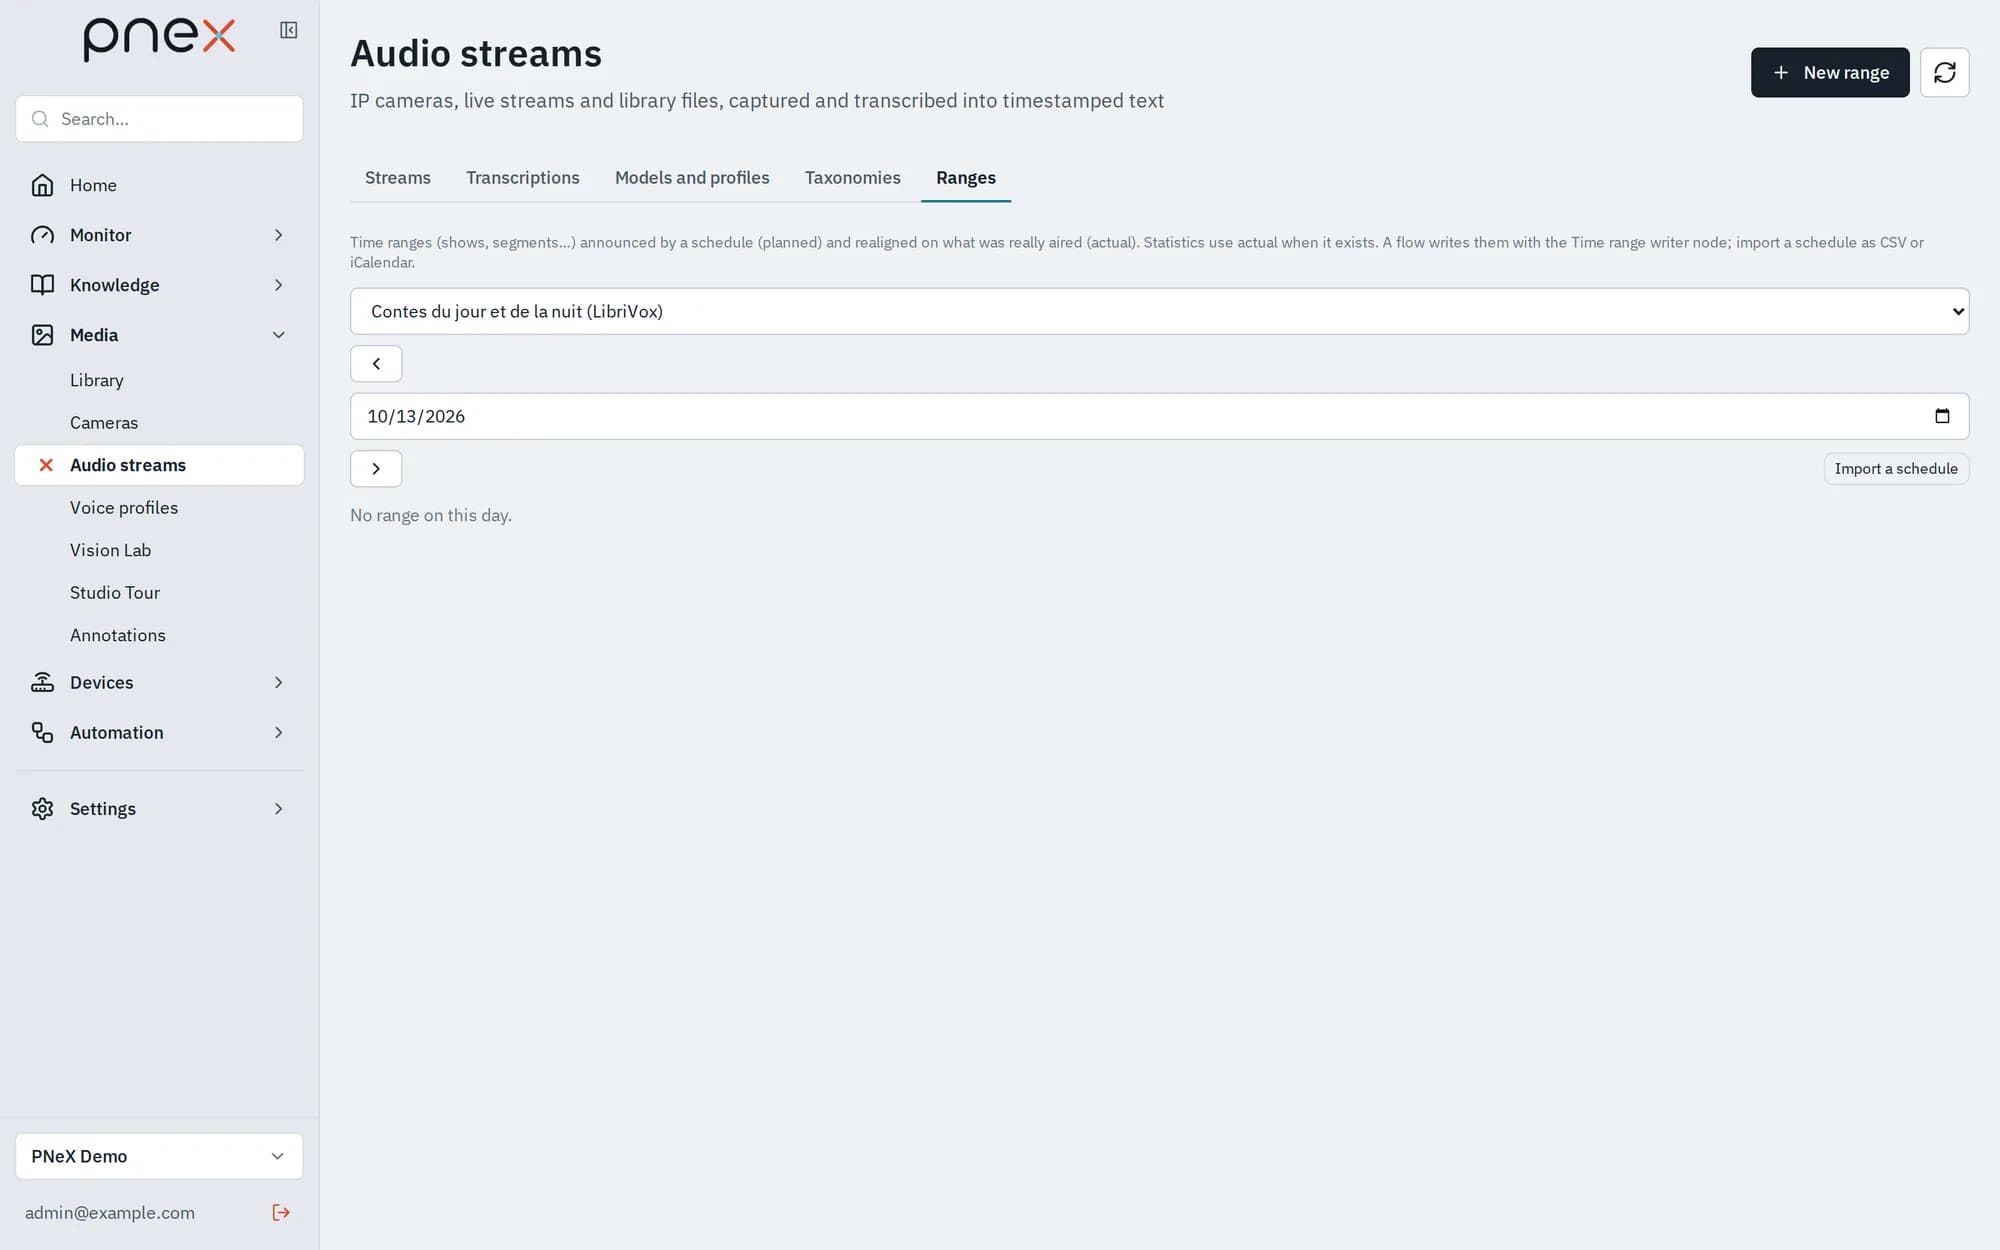
L’onglet Plages montre un jour à la fois pour un flux ou Toute l’organisation. Une frise trace deux barres par plage : la claire pour le prévu, la foncée pour le réel, si bien qu’un départ en retard se voit d’un coup d’œil. Chaque ligne donne son Origine (Grille, Détectée, EPG, Manuelle, Import) et un lien Source le cas échéant.
- Nouvelle plage : libellé, catégorie, Identifiant externe, début et fin prévus
et réels, lien source (
httpouhttps). Il faut au moins un couple d’horaires complet. - Importer une grille : un fichier CSV avec ligne d’en-tête (
labelobligatoire, plusexternal_id,planned_start,planned_end,actual_start,actual_end,category,source_url; horaires au format2026-10-12T07:00:00+02:00; séparateur virgule ou point-virgule) ou un fichier iCalendar.ics(UID,SUMMARY,DTSTART,DTENDouDURATION). Le résultat compte les plages créées, mises à jour et refusées, avec la ligne et la raison de chaque refus. Fichiers limités à 1 Mio et 5000 lignes.
L’identifiant externe repère une plage dans sa grille : réimporter le même fichier met les plages à jour au lieu de les dupliquer, et une cellule CSV vide laisse la valeur en place ; une grille réimportée n’efface donc jamais les horaires réels écrits par un flow.
Dans un flow, le nœud Écriture de plages enregistre chaque message comme une plage du flux choisi dans le nœud : une grille récupérée chaque nuit (Inject → Requête HTTP → Fonction → Écriture de plages), ou une annonce repérée dans les transcriptions (Source média → Fonction → Écriture de plages, avec les horaires réels). Pour des statistiques par émission ou par tranche horaire, ajoutez un widget Barres par plage / tranche à un tableau de bord.
Taxonomies et classifieur de sujets
Une taxonomie est une liste versionnée de sujets. Chaque sujet a un Identifiant
(minuscules, chiffres et _, stable dès que des séries l’utilisent), un Libellé, une
Définition et des Mots-clés. Chaque enregistrement crée une nouvelle version ; les
anciennes ne sont jamais réécrites.
- Nouvelle taxonomie (nom et description) démarre vide, en version 0.
- Nouvelle version modifie le tableau des sujets (jusqu’à 100 sujets, 50 mots-clés chacun), avec une Note (ce qui change), puis Enregistrer la version.
- Historique liste chaque version avec sa date, sa note et ses sujets.
Dans un flow, le nœud Classifieur de sujets (en général après une Source média)
choisit une taxonomie et épingle sa version courante. Chaque message reçoit topics (les
identifiants des sujets trouvés, éventuellement aucun) et taxonomy_version
(nom@version). Un sujet correspond quand l’un de ses mots-clés apparaît en mots entiers,
sans tenir compte de la casse ni des accents : bourse ne correspond pas à boursier.
Un sujet sans mot-clé ne correspond jamais.
Une nouvelle version n’atteint un flow que lorsque vous la choisissez dans le nœud et
redéployez. Mettez taxonomy_version dans les labels des séries écrites : une nouvelle
version démarre alors de nouvelles séries au lieu de se mélanger aux anciennes.
Les transcriptions sont le texte de quiconque diffuse : les flows les traitent comme des données, jamais comme des instructions.
Rôles
Tous les membres consultent flux, segments, enregistrements, transcriptions, plages et taxonomies. Owners, Admins et Members les créent et les modifient ; seuls les Owners et Admins posent un secret d’accès, ou déplacent un flux qui détient un secret vers une autre adresse ou sur un boîtier de capture. Les Viewers ne modifient rien.